Jules
Barth

Ingénieur IA / MLOps

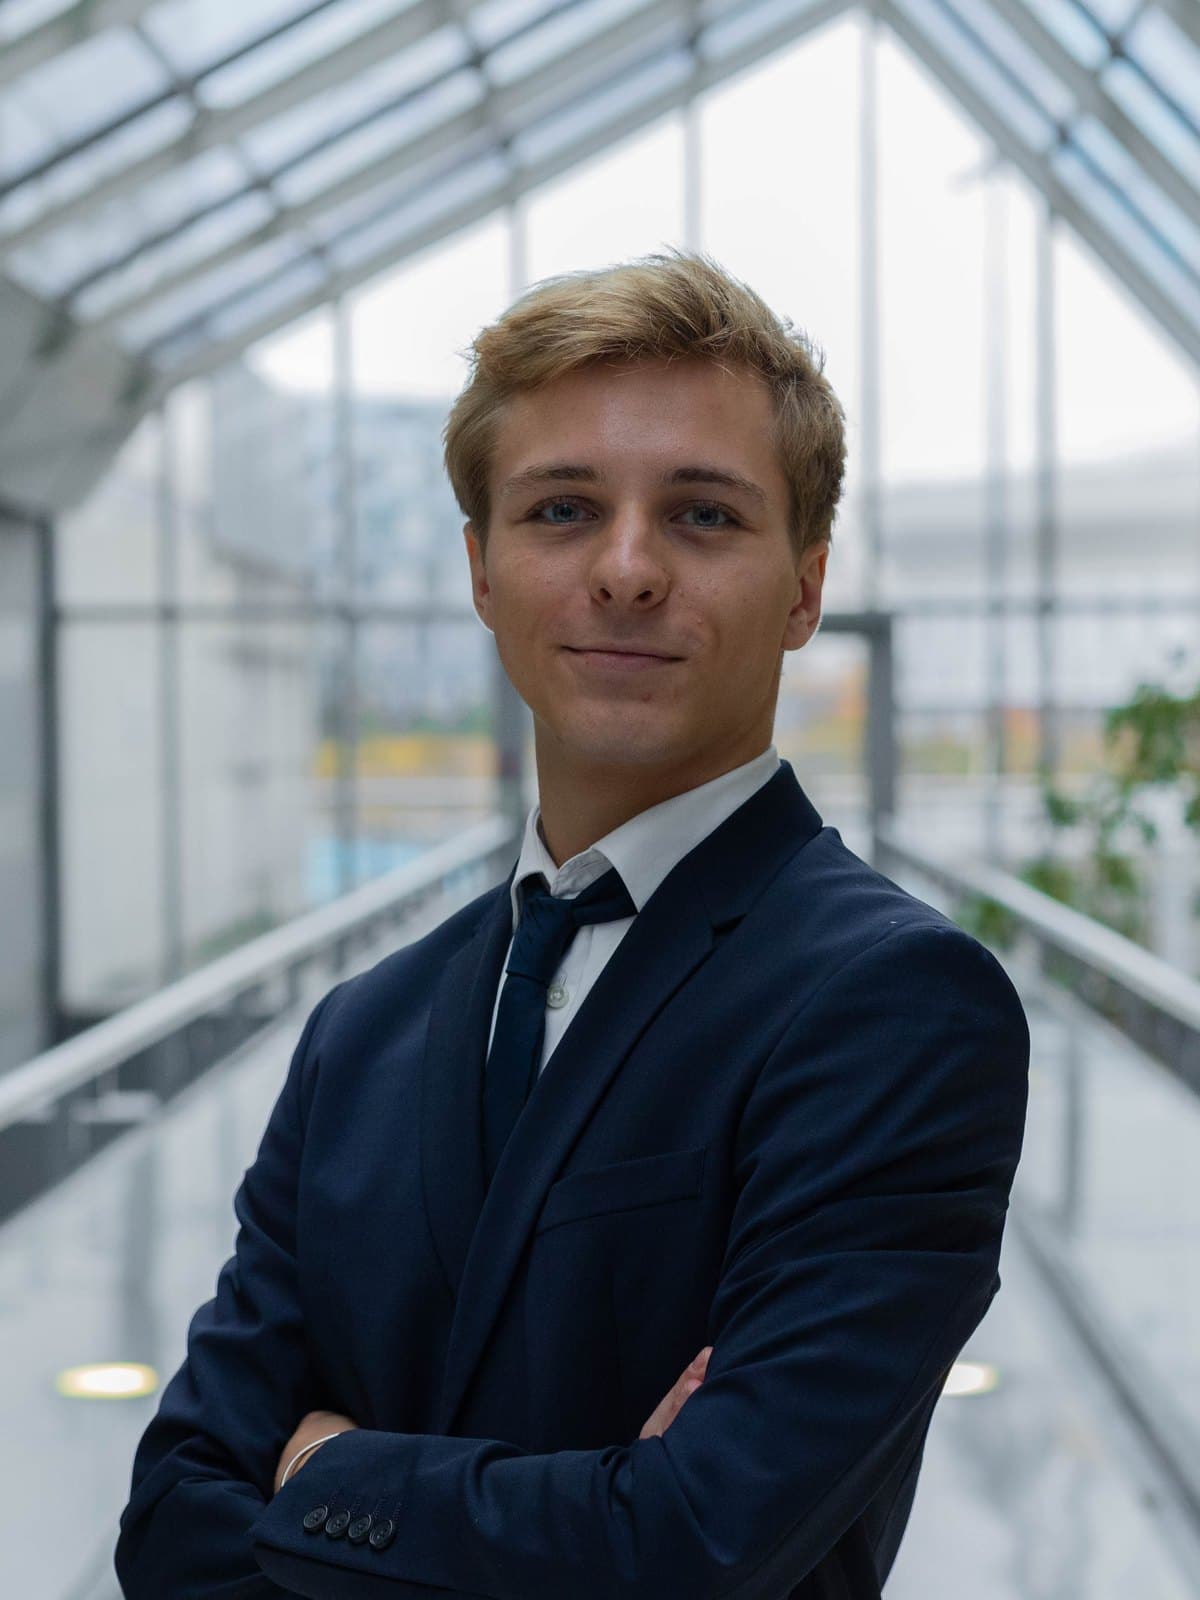
Portrait de Jules Barth en costume, bras croisés, dans une passerelle vitrée.

Je conçois et j'optimise des systèmes d'IA pour la production.

Stage MLOps chez Safran AI · 3 projets open source d'optimisation.Optimisation , compression de modèles, pipelines MLOps. (, ), compression par et sélection de couches par , pipelines MLOps de bout en bout.

Disponible en CDI dès novembre 2026.

Mesuré
résultat vérifié, avec la machine et la méthode.
Limite
ce qui ne fonctionne pas encore, dit clairement.

Trois projets d'optimisation de modèlesTrois projets pour alléger et accélérer les modèles d'IATrois projets pour alléger et accélérer les modèles d'IA

À gauche, ce que le projet affirme. À droite du trait, ce qui est mesuré et ce qui ne l'est pas.

AKO

Choisir automatiquement la version la plus rapide d'un calcul, après avoir vérifié qu'elle est exacte.Adaptive Optimizer. Un outil de validation pour remplacer des calculs dans un modèle de langage.Adaptive Optimizer. Un pour remplacer des kernels dans un d' .

Flux de sélection d'AKO : cinq candidats passent un contrôle de budget d'erreur, un est rejeté, les autres sont mesurés puis la décision est mise en cache.référenceF.rms_normtorch.compileTritonTriton tronquébenchmarkdécision en cachebudget (ulps)
Schéma du flux, pas une mesure. Le candidat tronqué illustre un kernel rapide mais faux, rejeté avant d'être mesuré.

Un calcul optimisé n'est pas plus rapide partout, et peut être faux sans le dire. AKO teste chaque variante, écarte les fausses et garde la plus rapide.Pour chaque opération, , et , AKO teste les candidats (référence, fusé, , ). Il rejette ceux qui sortent d'un exprimé en , mesure les autres et met la décision en cache, avec ses raisons.

Mesuré
Vérifie l'exactitude de chaque version avant de l'utiliser, et évite jusqu'à 55 % de ralentissement face à la version optimisée imposée partout. Mesuré sur un PC portable.Choisir la version par configuration évite jusqu'à 55 % de pénalité ( imposé) et 314 % sur ( imposé). Face à la meilleure : 1,03× à 1,17× en médiane. .Choisir par évite jusqu'à 55 % de pénalité ( imposé partout, qui perd sur 22 des 72 configurations ) et 314 % sur ( imposé partout). Face à la meilleure (presque toujours torch.compile) : 1,03× à 1,17× en médiane. Mesuré sur une .
Limite
Couvre trois opérations pour l'instant : effet sur un modèle complet d'environ 1 %.Trois opérations couvertes (≈ 24 % du temps d'un ) : impact global ≈ 1 %. En , 0,69× face au , cause à l'étude.Trois opérations couvertes (≈ 24 % du temps d'un ) : impact global ≈ 1 %. En , 0,69× face au , cause à l'étude.

· · · ·

QCompress

Compresser un modèle de langage par factorisation.Compression de modèles de langage par factorisation, inspirée du calcul quantique.Compression de par décomposition , inspirée du calcul quantique.

Une matrice dense est factorisée en une chaîne de quatre petits cœurs reliés par des rangs r1, r2, r3.W denseTT-SVDr1r2r3G1G2G3G4
Principe de la décomposition Tensor-Train. Les rangs sont fixés par la recette.

Remplace automatiquement les couches lourdes d'un modèle de langage par des versions factorisées, suivies dans un tableau de bord en temps réel.Les couches TTLinear et TTEmbedding remplacent les couches denses d'un modèle à partir d'une recette YAML. Un dashboard temps réel suit les métriques et compare le modèle original au modèle compressé.

Livré
Le remplacement est automatique ; le modèle compressé s'exporte et se compare à l'original.Remplacement automatique des couches, exports standards, comparaison du modèle original et du modèle compressé.Remplacement automatique des couches, export , SafeTensors et , dashboard FastAPI et Next.js.
Limite
Prochaine étape : mesurer et publier le taux de compression obtenu.Prochaine étape : mesurer et publier le taux de compression obtenu. Une seule famille de modèles (GPT-2) pour l'instant.Prochaine étape : mesurer et publier le taux de compression obtenu. Poids encore reconstruits à la volée, famille GPT-2 seulement.

· · · · FastAPI · Next.js

Q-GEOCompress

Alléger un détecteur d'images aériennes, sous contrôle de qualité.Compression d'un détecteur aérien, acceptée seulement si les seuils de fiabilité passent.Compression post-entraînement d'un détecteur aérien, acceptée seulement si les de fiabilité passent.

Paramètres retirés : 0,34 % pour la SVD simple, 20,67 % pour le pipeline data-aware. Les deux restent dans les mêmes seuils de qualité.0 %10 %20 %SVD simple−0,34 %Pipeline data-aware−20,67 %seuils tenusseuils tenus
Barres à l'échelle, mêmes seuils de qualité pour les deux méthodes.

Choisit les couches à compresser par une optimisation inspirée du quantique, et n'accepte le résultat que si le de précision et de fiabilité passe. sur . Le choix des couches à compresser est encodé en et résolu par (, brique optionnelle, repli classique), puis factorisé en bas rang. Le contrôle précision et avant d'accepter un candidat.

Mesuré
Un modèle 20 % plus léger, avec 61 fois plus de paramètres retirés que la méthode classique, en restant dans les seuils de qualité fixés.−20,67 % de paramètres (allocation des rangs selon les données) contre −0,34 % pour la méthode simple, dans les mêmes seuils de qualité. Précision () : 0,8007 contre 0,8943 au départ.−20,67 % de paramètres par allocation lagrangienne des rangs (data-aware), contre −0,34 % pour la simple, dans les seuils de qualité fixés ( −0,10 max, CER@0.8 +0,02 max). mAP50 de 0,8007 contre 0,8943 en , split test de 80 images, .
Limite
Aucun gain de vitesse mesuré sur pour l'instant. La vitesse du modèle allégé reste à mesurer, aussi sur .Aucun gain de latence mesuré sur pour une variante plus légère (−5,63 % de paramètres) : 96,0 ± 1,7 ms contre 98,8 ± 4,3 ms au départ. Prochaine étape : mesurer la latence du modèle −20,67 %, puis sur .Aucun gain de latence mesuré sur pour la variante top-5 pareto-gain (−5,63 % de paramètres) : 96,0 ± 1,7 ms contre 98,8 ± 4,3 ms en ; la latence du modèle −20,67 % n'est pas encore mesurée. Prochaines étapes : mesure sur , et brancher ce pipeline data-aware (encore une étude) dans la chaîne avec .

· · · · ·

Aussi : RAG et applications LLM

J'ai aussi construit des assistants qui répondent à partir de documents : recherche, , évaluation.Des applications de bout en bout : récupération, , évaluation.Des applications de bout en bout : récupération (), , évaluation.

  • Terros (HelloLeo)Un assistant qui retrouve plus de 400 éléments d'interface, pour les réutiliser au lieu de les refaire.Prototype d'assistant qui retrouve plus de 400 composants d'interface, pour favoriser leur réutilisation.Prototype de sur plus de 400 composants UI pour favoriser leur réutilisation.
  • HR FAQ Chatbot (DSPy)Un assistant de questions RH pour une entreprise fictive : modèle ajusté, recherche dans les documents, rejet des questions hors sujet, évaluation.Assistant RH pour une entreprise fictive : modèle ajusté, , recherche documentaire, rejet des questions hors domaine.Assistant RH pour une entreprise fictive : , optimisation , , rejet des questions hors domaine, reproductible.Dépôt HR FAQ Chatbot (DSPy)
  • ESILV Smart AssistantUn assistant pour l'école, fait de plusieurs : il répond aux questions et aide à remplir des formulaires.Système : recherche documentaire, remplissage de formulaires, coordination des .Système : , remplissage de formulaires, orchestration.Dépôt ESILV Smart Assistant

Autres projets

  • qllm-pbitsChoisir les mots d'un modèle de langage avec un réseau simulé de bits aléatoires.Échantillonner les d'un avec un réseau simulé de .Simulateur de réseau de pour échantillonner des depuis la distribution d'un ( sur variables binaires, pénalité one-hot).Dépôt qllm-pbits
  • MistralTuneUne plateforme pour adapter un modèle de langage à ses propres données, en ligne ou en local.Plateforme de Mistral : API cloud ou entraînement local, suivi des jobs, comparaison de modèles.Plateforme de Mistral : API cloud, local, suivi des jobs et des datasets, comparaison de modèles.Dépôt MistralTune
  • Sentiment Analysis with FHEAnalyser le ton d'un texte sans jamais déchiffrer les données. sur des données qui restent chiffrées de bout en bout. sous chiffrement totalement homomorphe () : les données restent chiffrées de bout en bout.Dépôt Sentiment Analysis with FHE

Expérience

Mon terrain : faire passer un modèle de l'expérimentation à la production.Mon terrain : faire passer un modèle de l'expérimentation à la production.

  1. avril – septembre 2026

    Ingénieur MLOps (stage) — Safran AI

    Industrialisation d'une plateforme MLOps : suivi d'expériences, déploiement, évaluation et monitoring de modèles, pipelines , intégration d'outils open source comme , documentation.Industrialisation d'une plateforme MLOps : suivi d'expériences, déploiement, évaluation et monitoring de modèles. Automatisation des pipelines ML (, gestion des artefacts), intégration d'outils open source comme , travail sur la performance et la reproductibilité des workflows, documentation de la plateforme.

    Technologies : Python, SQL, PyTorch, TensorFlow, Scikit-Learn, ONNX, TorchScript, MLflow, Docker, Kubernetes, GitLab CI, GitHub Actions, AWS, Linux.

  2. avril – août 2025

    Product Engineer — Terros (HelloLeo)

    Contribution à HelloLeo, assistant de développement IA collaboratif. Refonte et mise en ligne du site helloleo.dev. Optimisation des instructions des modèles (Claude, Gemini) et architecture multi-modèles. Prototype de sur plus de 400 composants d'interface.Contribution à HelloLeo, assistant de développement IA collaboratif. Refonte et mise en ligne du site helloleo.dev (déploiement Netlify, SEO et performance). Optimisation des instructions des modèles (Claude, Gemini) et architecture multi-modèles pour des réponses cohérentes. Prototype de sur plus de 400 composants UI.
  3. octobre 2022 – novembre 2024

    Responsable technique — SGN

    Fédération française des associations étudiantes d'e-sport : développement et maintenance du site, design responsive, optimisation des performances, documentation technique.Fédération française des associations étudiantes d'e-sport : développement et maintenance du site, design responsive, optimisation des performances, documentation technique et guidelines de l'organisation.

Autres expériences

  • BDE Veni Vidi De Vinci : communication et événementiel.
  • septembre 2021 – mai 2022DevinciTrip (ESILV) : vice-président de l'association.
  • Jobs étudiants : service client, restauration, cours particuliers de maths et d'informatique.

Formation

Formé à l'ESILV (diplôme d'ingénieur, majeure Data & IA), avec un parcours en informatique quantique.

  1. Data Intelligence, AI & Quantum Track

    ESILV — Diplôme d'ingénieur (grade master), majeure Data & IA

    Promotion 2026. Parcours informatique quantique : algorithmes quantiques, applications hybrides, cryptographie post-quantique.Promotion 2026. Parcours informatique quantique : algorithmes quantiques, applications hybrides, cryptographie post-quantique.

    Machine Learning, Deep Learning, Computer Vision · et IA générative · Big Data & Spark · Pipeline BI et analyse de données · Informatique quantique avancée et applications · Cryptographie post-quantique · Data Protection Management, Product Lifecycle Management.

  2. Baccalauréat scientifique et High School Diploma américain (double diplôme, 2020)

Langues : français natif, anglais B2 (TOEFL et Cambridge).

Compétences

Python, , , , , , ,

Langages et données
Python, SQL, JavaScript, TypeScript, C++, C#, R, Spark, PostgreSQL, MySQL, MongoDB
IA et ML
, TensorFlow, Scikit-Learn, NumPy, Pandas, (Transformers), Ultralytics (YOLO)
LLM et RAG
/ , , , Chroma,
Inférence et GPU
, , , , , TensorRT
MLOps et déploiement
, , , GitLab CI, GitHub Actions, AWS, pytest, Git, Linux, WSL2
Compression et quantique
, , , ,
Web
Next.js, React, Node.js, Vue.js, FastAPI, Pydantic, WebSockets

Écrivez-moi

Je cherche un CDI d'ingénieur IA ou MLOps, à partir de novembre 2026.

julesbarth13@gmail.com

En dehors du code : rugby (11 ans au RC Suresnes, puis en universitaire), ski, escalade, snowboard.

Niveau de détail