AKO
Adaptive Kernel Optimizer
Un outil qui vérifie qu'une version optimisée d'un calcul reste juste avant de l'utiliser, puis garde la plus rapide, cas par cas.Un outil qui vérifie qu'un calcul optimisé reste juste avant de l'utiliser, puis garde le plus rapide, par shape.Un pour remplacer des dans un d' : chaque candidat est vérifié avant usage, puis choisi par shape.
Mesuré sur un seul PC portable (carte graphique RTX 3070). Rien n'est affirmé pour d'autres machines.Mesuré sur une . Aucune affirmation sur d'autres .Mesuré sur une . Aucune affirmation sur d'autres .
Le problème
Un calcul optimisé n'est pas plus rapide partout, et il peut être faux sans le dire.Un calcul optimisé n'est pas plus rapide partout, et il peut être faux sans le dire.Un n'est pas plus rapide partout, et il peut être faux sans le dire.
La version « rapide » perd parfois face à . Elle peut aussi gagner en sautant une partie des données. Il faut vérifier avant de choisir.Sur 72 configurations testées, la version optimisée perd face à dans 22 cas, jusqu'à 55 %. Une version peut aussi gagner en ignorant des données, et un seuil d'erreur fixe rejette des versions correctes. AKO apporte un contrat de justesse.Sur la RTX 3070, le perd face à sur 22 des 72 configurations × , jusqu'à 55 % ( : 8 shapes sur 36 en , 14 sur 36 en ). Un dont BLOCK_SIZE plafonne à 8192 tronque les lignes plus larges et gagne quand même le . Un seuil fixe max_abs_error < 1e-2 rejette un kernel correct en bf16, à 1,00 d'écart. Remplacer un kernel n'a pas de contrat numérique : AKO en fournit un.
Approche
Valider avant de mesurer, mesurer avant de choisir, garder la raison du choix.
La première fois qu'un calcul se présente, AKO essaie toutes les versions, écarte celles qui se trompent, chronomètre les autres et retient la plus rapide.Au premier appel, AKO exécute toutes les versions candidates, rejette celles dont l'erreur dépasse une tolérance adaptée à la précision des nombres, mesure les autres et enregistre la décision avec ses raisons. La version standard reste toujours candidate.Au premier appel pour une opération, un , une et un , AKO exécute tous les candidats enregistrés (, F.rms_norm, , ). Ceux dont l'erreur dépasse le budget sont rejetés ; un candidat qui lève une exception est écarté. Ce budget, exprimé en , dépend de la précision du dtype et de la magnitude du résultat ; il n'est jamais codé en dur. Les survivants sont mesurés (), et la décision est écrite dans un cache lisible (~/.ako/kernel_cache.json), avec ses métriques.
Trois opérations couvertes, chacune testée automatiquement.Opérations couvertes : , residual + RMSNorm fusé, (neox et interleaved). La reste toujours candidate. testés sans via TRITON_INTERPRET=1 ; type LLaMA vérifié contre transformers (égalité exacte en ). 107 tests sans GPU, 18 tests GPU.
- cache vide
- validation
- benchmark
- décision en cache
- Référence non fuséebenchmarké
- F.rms_norm (PyTorch)benchmarké
- torch.compilebenchmarké
- Tritonchoisi, mis en cache
- Triton tronquéhors budget
Résultats
Face à la meilleure option de : 1,03 à 1,17 fois plus rapide, en médiane. C'est le gain réel. Face à une version de base non optimisée : 7,3 fois, un chiffre qui mesure surtout la lenteur de cette version.Face à la meilleure : 1,03× à 1,17× en médiane. C'est le gain réel. Face à la : 7,3× sur , un chiffre qui mesure surtout son trafic mémoire.Médianes sur une , 2.6, 12.4, WSL2. Le gros chiffre mesure surtout le trafic mémoire de la ; la colonne utile est celle de la meilleure (presque toujours ).
| Opération | dtype | vs référence non fusée | vs meilleure baseline | Shapes perdues |
|---|---|---|---|---|
| RMSNorm | fp16 | 7,30× | 1,07× | 8 / 36 |
| RMSNorm | bf16 | 6,95× | 1,03× | 14 / 36 |
| RoPE | fp16 | 5,31× | 1,17× | 1 / 8 |
| RoPE | bf16 | 5,40× | 1,07× | 3 / 8 |
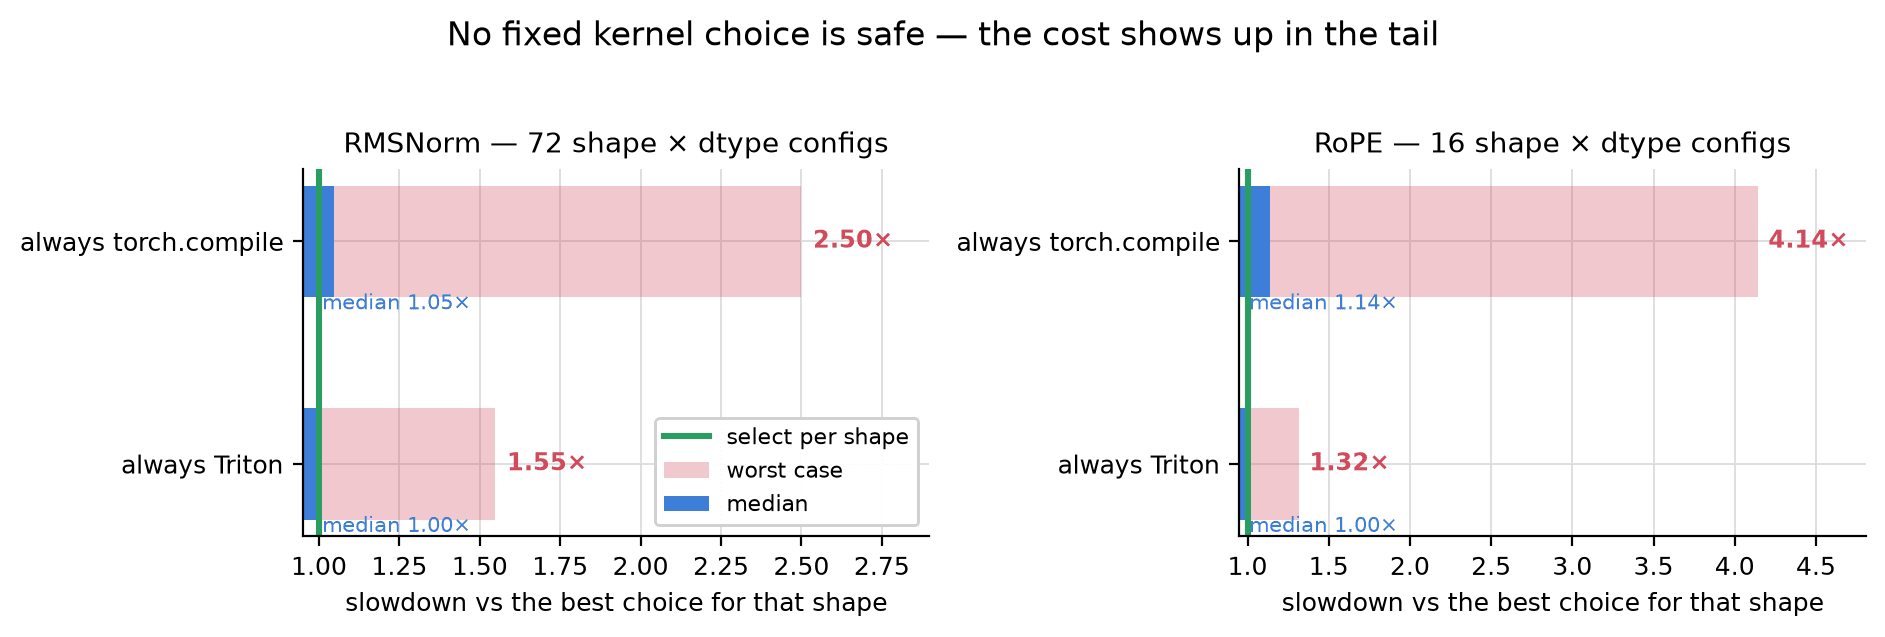
La valeur du projet : vérifier chaque version avant de l'utiliser, et choisir au cas par cas, car aucune ne gagne partout.La valeur du projet : sur les configurations mesurées, choisir par évite jusqu'à 55 % de pénalité ( imposé partout) et jusqu'à 314 % sur ( imposé partout).Tableau ci-dessous, puis pénalités et sensibilité.
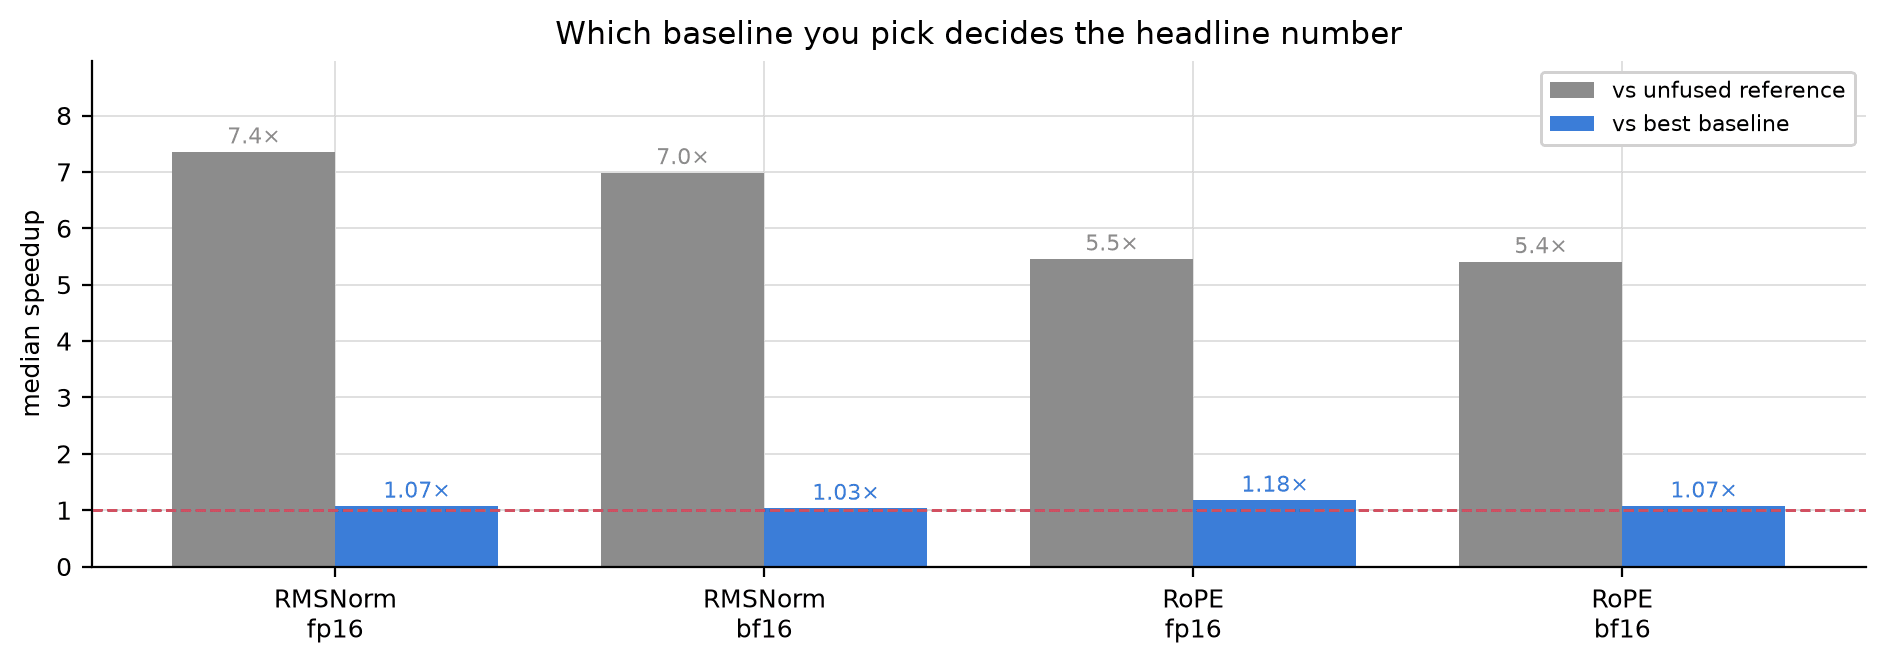
- Gain réel face à ce que PyTorch fournit déjà : 1,0× à 1,2×.
- Pénalité face au meilleur choix par shape (médiane / moyenne géométrique / pire cas) : Triton imposé 1,00× / 1,04× / 1,55× ; torch.compile imposé 1,04× / 1,09× / 2,50× ; F.rms_norm imposé 6,65× / 5,66× / 8,81× ; sélection par shape 1,00× partout. Sur RoPE, torch.compile imposé coûte jusqu'à 314 %.
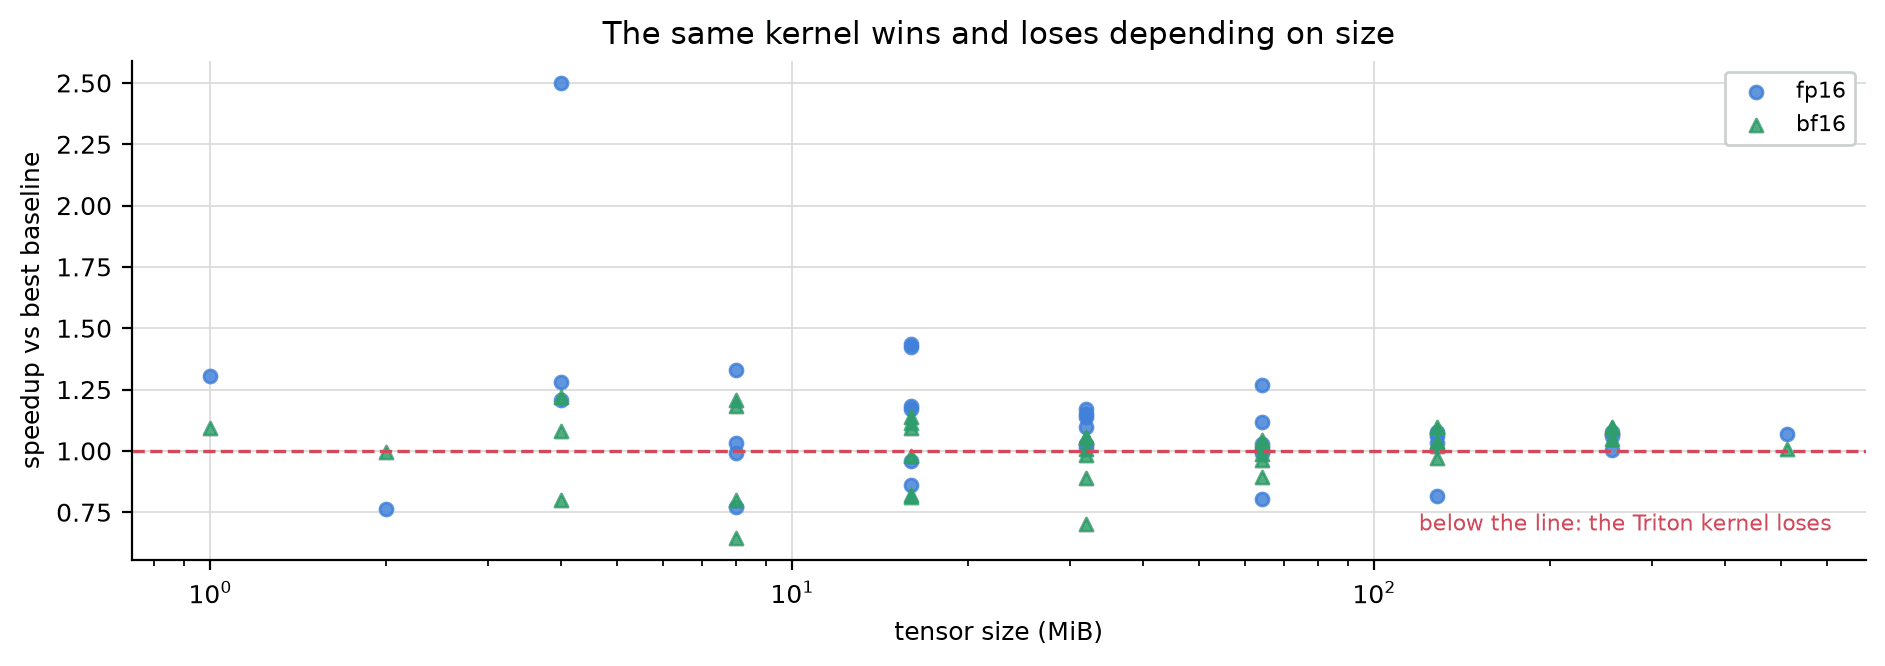
- Sensibilité : le même kernel gagne 2,5× à 4 MiB et perd 35 % à 8 MiB, même dtype.
- Exemple de décision en cache : rmsnorm_triton p50 0,319 ms contre rmsnorm_compiled 0,341 ms (1,07×), erreur max 0,00195 pour un budget de 0,0234.
Limites
En génération de texte, compilé reste devant (0,69×), cause à l'étude. Impact estimé sur le modèle entier : environ 1 %. Un seul ordinateur testé.En , 0,69× face au , cause à l'étude. Les opérations couvertes pèsent environ 24 % du temps d'un : impact global d'environ 1 %. Un seul mesuré ; attention et calcul matriciel non couverts.
- En decode, 0,69× face au stack compilé. Régression non expliquée à ce jour ; les sweeps n'incluent pas de shapes de decode.
- Opérations couvertes ≈ 24 % du temps d'un decoder : impact global estimé à environ 1 %.
- torch.compile plus lent qu'eager sur le stack (10,75 ms contre 10,39 ms en prefill, recompilations) : le 1,24× en prefill est optimiste.
- Matmul quantisé INT8/INT4 (~50 % du temps) et attention IO-aware (~25 %) non commencés. Pas de GEMM.
- Un seul GPU mesuré : aucune affirmation de portabilité matérielle.
- Pas un serveur d'inférence, pas une bibliothèque de kernels (3 opérations), NVIDIA uniquement.
- Pas sur PyPI, pas de versionnement sémantique.
Voir le code sur GitHub (github.com/Farx1/AKO)Projet suivant : QCompress